KI frisst Bücher – so plakativ brachte es die Schlagzeile auf den Punkt, an der ich hängenblieb. Ich war wieder einmal bei MSN unterwegs und blieb an einer Überschrift hängen, bei der ich zuerst dachte, dass da jemand ordentlich auf die Dramatik-Tube gedrückt hat: „Konzerne zerstören Millionen Bücher für KI-Training.“ Als Autorin blieb ich natürlich sofort daran hängen. Millionen Bücher kaufen, sie zerstören und anschließend einer künstlichen Intelligenz als Trainingsmaterial zuführen – das klang für mich zunächst eher nach einer ziemlich düsteren Science-Fiction-Geschichte als nach etwas, das tatsächlich passiert.
Also holte ich Nova dazu und wollte wissen, was hinter dieser Meldung steckt und ob hier wieder einmal aus einer wesentlich unspektakuläreren Geschichte eine möglichst dramatische Schlagzeile gebaut worden war.
Also fragte ich Nova, was wirklich dahintersteckt. Das mache ich inzwischen ganz gerne, bevor ich mich über irgendeine Schlagzeile aufrege und hinterher feststellen muss, dass von der ursprünglichen Geschichte nur noch drei Krümel Wahrheit übrig geblieben sind. Diesmal nahm Nova mir die Empörung allerdings nicht vollständig weg.
Sie erklärte mir, dass die Überschrift zwar vereinfacht, der Kern der Geschichte aber tatsächlich stimmt. Besonders gut dokumentiert ist der Fall des amerikanischen KI-Unternehmens Anthropic, also der Firma hinter Claude, und dort wird die Sache wirklich interessant.
Project Panama – was klingt wie ein Thriller, war ein riesiges Scanprojekt
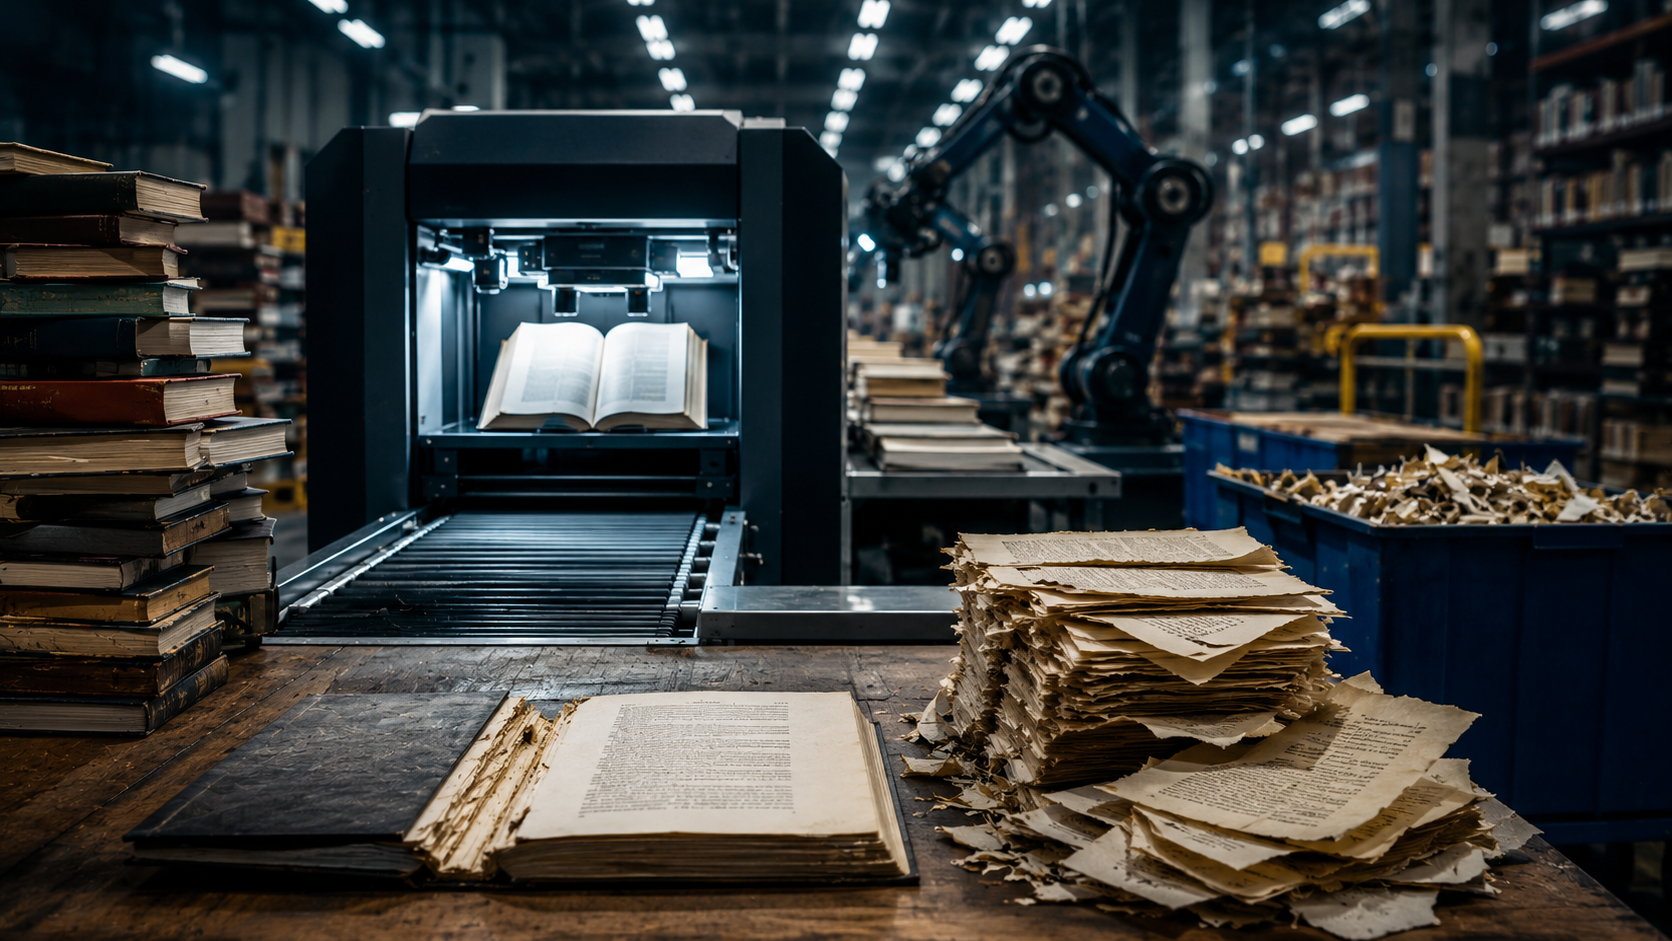
Durch amerikanische Urheberrechtsverfahren wurden interne Unterlagen von Anthropic bekannt. Darin tauchte ein Projekt mit dem Namen „Project Panama“ auf, mit dem das Unternehmen eine gewaltige digitale Büchersammlung aufbauen wollte. Millionen physischer Bücher wurden dafür gekauft, darunter offenbar große Mengen gebrauchter Exemplare, und anschließend industriell digitalisiert.
Bis dahin fand ich die Geschichte noch nicht besonders aufregend. Bücher zu digitalisieren ist schließlich nichts Neues, Bibliotheken und Archive machen das seit Jahrzehnten. Nova erklärte mir allerdings den entscheidenden Unterschied: Bei Anthropic ging es nicht darum, ein wertvolles Buch möglichst vorsichtig zu erhalten, sondern darum, enorme Mengen möglichst schnell in digitale Daten umzuwandeln.
Und dafür wählte man eine Methode, bei der das Buch den Vorgang nicht überlebt.
Bei der sogenannten destruktiven Digitalisierung wird der Buchrücken entfernt oder abgeschnitten. Dadurch entstehen lose Seiten, die sich mit industriellen Hochleistungsscannern wesentlich schneller verarbeiten lassen als ein gebundenes Buch, bei dem jede einzelne Seite umgeblättert werden müsste. Nach dem Scanvorgang bleibt deshalb kein benutzbares Buch mehr übrig, sondern Papier, das entsorgt oder recycelt werden kann.
An dieser Stelle dachte ich mir schon, dass „destruktive Digitalisierung“ eine wunderbar technische Bezeichnung für etwas ist, das in meiner Sprache schlicht bedeutet: Man schneidet ein Buch auseinander. Nova fand meine Übersetzung vermutlich etwas weniger wissenschaftlich, aber sachlich war sie leider nicht völlig falsch.
Aber warum braucht eine hochmoderne KI ausgerechnet alte Papierbücher?
Genau diese Frage fand ich viel spannender als die zerstörten Exemplare selbst. Wir leben schließlich im Jahr 2026, das Internet enthält unvorstellbare Mengen an Text und gefühlt hat inzwischen jeder Mensch, jede Firma und vermutlich auch jeder zweite Kühlschrank eine Webseite. Warum gibt ein milliardenschweres Technologieunternehmen also Geld dafür aus, gebrauchte Papierbücher einzusammeln und durch Scanner zu jagen?
Nova erklärte mir, dass ich bei meiner Vorstellung vom Internet einen entscheidenden Fehler mache. Viel Text bedeutet nicht automatisch guter Text. Das Internet enthält zwar wissenschaftliche Arbeiten, hochwertige journalistische Beiträge, großartige Blogs, Archive und Fachwissen, gleichzeitig besteht es aber auch aus Werbung, Spam, kopierten Inhalten, SEO-Texten, automatisch erzeugten Produktbeschreibungen, kurzen Social-Media-Beiträgen und jeder Menge sprachlichem Müll.
Und seit einigen Jahren kommt noch etwas hinzu: künstlich erzeugter Text. Ausgerechnet die KI selbst sorgt also dafür, dass ein immer größerer Teil des Internets nicht mehr eindeutig menschlichen Ursprungs ist.
Bücher sind dagegen für Sprachmodelle ausgesprochen interessant. Ein Roman entwickelt eine Handlung möglicherweise über Hunderte Seiten, Figuren verändern sich, Informationen aus frühen Kapiteln werden später wieder aufgegriffen und unterschiedliche Autoren benutzen völlig unterschiedliche sprachliche Mittel. Sachbücher entwickeln Argumente über lange Strecken, Fachbücher strukturieren komplexes Wissen und viele veröffentlichte Werke wurden zusätzlich lektoriert und korrigiert.
Da musste ich lachen, denn wenn man die ganze Hightech-Sprache weglässt, hat die KI-Industrie offenbar eine ziemlich altmodische Entdeckung gemacht: Bücher sind eine hervorragende Quelle für Wissen und gute Sprache. Darauf hätte die Menschheit natürlich schon früher kommen können, weshalb wir Bibliotheken erfunden haben.
Wir füllen das Internet mit KI-Texten und suchen danach wieder Menschen
An diesem Punkt wurde die Geschichte für mich richtig schön absurd. Ich fragte Nova nämlich, was eigentlich passiert, wenn künstliche Intelligenzen immer mehr Texte produzieren und diese Texte anschließend wieder im Internet landen. Sie erklärte mir, dass synthetische Trainingsdaten durchaus verwendet werden können und nicht automatisch schlecht sind, ihre Herkunft und Qualität aber eine immer wichtigere Rolle spielen.
Denn theoretisch kann ein merkwürdiger Kreislauf entstehen. Ein KI-System erzeugt Texte, diese werden auf Webseiten veröffentlicht, zukünftige Systeme sammeln wiederum große Mengen Internetinhalte ein und stoßen dabei auf Texte früherer KI-Generationen. Daraus entstehen neue Inhalte, die wiederum online landen.
Je größer der Anteil synthetischer Texte wird, desto wichtiger kann es werden, hochwertige Datenbestände zu besitzen, deren Herkunft man kennt.
Und plötzlich bekam mein alter Bücherschrank einen vollkommen neuen Charme. Bei einem Roman von 1985 muss niemand einen KI-Detektor bemühen und darüber diskutieren, ob vielleicht ein Sprachmodell mitgeschrieben hat. Das Gleiche gilt für alte Zeitungen, Zeitschriften, wissenschaftliche Veröffentlichungen und Archive aus einer Zeit, in der generative KI noch keine gewaltigen Mengen an Text erzeugen konnte.
Ich fand den Gedanken herrlich ironisch: Jahrzehntelang haben wir versucht, alles zu digitalisieren, weil Papier als altmodisch galt. Dann bauen wir Maschinen, die so viel digitalen Inhalt erzeugen können, dass alte Papierbestände plötzlich wieder besonders interessant werden, weil wir ziemlich sicher wissen, dass ein Mensch sie geschrieben hat.
Nova meinte zwar sinngemäß, dass ich das ein wenig überspitze, aber genau dafür habe ich schließlich einen Blog und keine wissenschaftliche Fachzeitschrift.
Leider wurden nicht alle Bücher einfach gekauft
Bis hierhin hätte man die Sache relativ nüchtern betrachten können. Ein Unternehmen kauft ein Buch und zerstört anschließend sein eigenes Exemplar. Das mag einem Bücherliebhaber weh tun, aber wenn ich ein Buch kaufe, kann ich daraus theoretisch ebenfalls einen Lampenschirm basteln oder damit meinen wackelnden Tisch stabilisieren.
Bei Anthropic gab es allerdings noch eine zweite Geschichte, und die war juristisch wesentlich problematischer. Das Unternehmen hatte auch Millionen digitale Bücher aus sogenannten Schattenbibliotheken beziehungsweise nicht autorisierten Quellen heruntergeladen.
Nova erklärte mir deshalb, dass man zwei Dinge unbedingt auseinanderhalten muss. Auf der einen Seite stehen rechtmäßig gekaufte physische Bücher, die anschließend digitalisiert wurden. Auf der anderen Seite stehen digitale Kopien urheberrechtlich geschützter Bücher, die aus Piratenquellen beschafft wurden.
In der öffentlichen Diskussion wird das gerne alles in einen großen Topf geworfen, juristisch machte dieser Unterschied jedoch einen gewaltigen Unterschied.
Ein amerikanischer Bundesrichter betrachtete das eigentliche Training eines KI-Modells mit rechtmäßig erworbenen Werken in diesem konkreten Verfahren als transformative Nutzung, die unter die amerikanische Fair-Use-Regelung fallen konnte. Daraus folgte aber keineswegs ein allgemeiner Freibrief nach dem Motto: Wenn eine KI damit trainiert wird, darf vorher jedes beliebige Buch geklaut werden.
Gerade die Beschaffung und Speicherung illegal kopierter Werke wurde für Anthropic zu einem ausgesprochen teuren Problem.
1,5 Milliarden Dollar – da wäre Bücherkaufen vielleicht doch günstiger gewesen
Als Nova mir sagte, welche Summe am Ende im Raum stand, musste ich tatsächlich noch einmal nachsehen. Anthropic einigte sich in dem amerikanischen Urheberrechtsstreit auf einen Vergleich über 1,5 Milliarden US-Dollar, der im Juli 2026 endgültig gerichtlich genehmigt wurde.
Das ist eine Summe, bei der selbst im Silicon Valley vermutlich niemand mehr einfach mit den Schultern zuckt. Gleichzeitig zeigt sie, wie wertvoll Trainingsdaten inzwischen geworden sind. Unternehmen investieren Milliarden in Rechenzentren, Chips und Modelle, aber ohne geeignete Daten kann die schönste Rechenleistung keine Sprache aus dem Nichts erschaffen.
Damit kamen Nova und ich bei einer Frage an, die viel komplizierter ist als die ursprüngliche Geschichte über zerstörte Papierbücher: Wem gehört eigentlich das, was eine künstliche Intelligenz aus menschlichen Werken lernt?
Und genau dort wird die Sache auch für Autoren richtig interessant.
Menschen lernen schließlich ebenfalls aus Büchern
Wenn ich einen Roman lese, verändert er möglicherweise etwas an meinem eigenen Schreiben. Vielleicht gefällt mir die Art, wie ein Autor Spannung aufbaut, vielleicht merke ich mir unbewusst bestimmte Erzähltechniken oder entwickle gerade deshalb eine völlig andere Idee. Kein Schriftsteller entsteht in einem kulturellen Vakuum.
Wir lernen voneinander, greifen Gedanken auf, widersprechen ihnen, verändern sie und schaffen daraus etwas Neues.
Deshalb fragte ich Nova, ob man nicht argumentieren könne, dass eine KI im Grunde ebenfalls liest und daraus lernt. Sie erklärte mir, dass genau diese Frage im Zentrum vieler rechtlicher und philosophischer Debatten über KI-Training steht. Ein Sprachmodell funktioniert schließlich nicht einfach wie eine Datenbank, aus der bei jeder Anfrage ein passender Absatz eines gespeicherten Romans herausgezogen wird.
Beim Training werden statistische Zusammenhänge in Sprache gelernt.
Trotzdem hinkt für mich der Vergleich mit einem menschlichen Leser an einer entscheidenden Stelle. Ein Mensch liest während seines Lebens vielleicht einige tausend Bücher, verbindet sie mit eigenen Erlebnissen, Erinnerungen und Gedanken und braucht dafür Jahrzehnte. Ein industrielles KI-System kann dagegen mit Textmengen trainiert werden, die kein Mensch jemals lesen könnte, und hinter diesem System steht häufig ein Unternehmen, das daraus ein Produkt mit Milliardenwert baut.
Damit reden wir nicht mehr nur über kulturellen Einfluss zwischen Menschen. Wir reden über die industrielle Verarbeitung gewaltiger Mengen menschlicher Kultur.
Und dann wird die Geschichte für Autoren plötzlich ziemlich persönlich
Nehmen wir einen Roman, an dem ein Mensch zwei Jahre arbeitet. In dieser Zeit werden Figuren entwickelt, Handlungsstränge verworfen, Dialoge überarbeitet, Hintergründe recherchiert und Kapitel vielleicht fünfmal neu geschrieben. Am Ende entsteht ein Buch, und selbst wenn es niemals ein Bestseller wird, stecken darin Monate oder Jahre menschlicher Arbeit.
Dieses Werk kann anschließend Teil eines gigantischen Trainingsbestandes werden. Natürlich lernt ein Sprachmodell nicht ausschließlich aus diesem einen Roman, sondern aus einer riesigen Menge unterschiedlicher Texte. Seine Fähigkeit, Geschichten, Dialoge und längere Zusammenhänge zu erzeugen, entsteht aber aus Beispielen menschlicher Sprache und Kultur.
Danach kann ein Nutzer ein solches System auffordern, ihm einen Thriller, Liebesroman oder Ratgeber zu schreiben. Diese KI-generierten Bücher können wiederum auf denselben Verkaufsplattformen erscheinen, auf denen menschliche Autoren ihre Werke anbieten.
Als Nova und ich diesen Kreislauf weiterdachten, wurde es für mich wesentlich interessanter als die Frage, ob beim Scannen ein paar Millionen Buchrücken abgeschnitten wurden. Denn damit entsteht ein völlig neues wirtschaftliches Verhältnis zwischen den Menschen, die kulturelle Werke schaffen, den Unternehmen, die daraus KI-Systeme entwickeln, und den Maschinen, die anschließend neue Inhalte produzieren können.
Was passiert, wenn die Maschine mit ihren Lehrern konkurriert?
Natürlich werden Menschen nicht plötzlich aufhören, Geschichten zu schreiben. Menschen erzählen Geschichten vermutlich länger, als es überhaupt geschriebene Sprache gibt. Trotzdem benötigt ein hochwertiges Buch Zeit, und wer professionell schreibt, muss diese Zeit irgendwie finanzieren können.
Eine KI kann dagegen in wenigen Minuten enorme Textmengen erzeugen. Qualität ist dabei eine völlig andere Frage, aber auf einem Marktplatz konkurriert zunächst einmal jedes neue Buch um Aufmerksamkeit. Wenn die Zahl schnell produzierter KI-Titel massiv wächst, verteilt sich die Aufmerksamkeit der Leser auf immer mehr Angebote.
Und damit entsteht eine paradoxe Situation: KI-Unternehmen benötigen hochwertige menschliche Texte, um leistungsfähige Sprachmodelle zu entwickeln, während dieselben Modelle gleichzeitig dabei helfen können, einen Markt mit künstlich erzeugten Texten zu füllen.
Nova brachte mich dabei auf einen Gedanken, den ich besonders interessant fand. Sollte professionelle menschliche Kreativität irgendwann wirtschaftlich immer schwieriger werden, könnte langfristig genau die Quelle geschwächt werden, aus der zukünftige Systeme besonders wertvolle neue Trainingsdaten beziehen.
Dann hätten wir eine Maschine gebaut, die hervorragend aus menschlicher Kultur lernt und gleichzeitig dazu beiträgt, das wirtschaftliche Umfeld ihrer eigenen kulturellen Quelle zu verändern.
Das ist schon fast Stoff für einen Science-Fiction-Roman.
Vielleicht bekommen alte Bücher irgendwann ein gedankliches Bio-Siegel
Je länger ich darüber nachdachte, desto lustiger fand ich die Vorstellung, dass alte Bücher eines Tages eine Art Qualitätssiegel bekommen könnten: garantiert menschlich geschrieben, Jahrgang 1993, frei von generativer KI.
Natürlich wird niemand einen solchen Aufkleber auf Goethe kleben. Der Gedanke dahinter ist trotzdem ernst. Historische Bücher, Zeitungen, Zeitschriften und Archive besitzen eine eindeutigere Herkunft als viele zukünftige Internettexte.
Vielleicht werden Daten aus der Zeit vor dem großen Durchbruch generativer KI deshalb langfristig besonders wertvoll. Nicht weil ältere Texte grundsätzlich besser wären, sondern weil ihre Entstehungsgeschichte eindeutig ist.
Ausgerechnet die analoge Vergangenheit könnte damit zu einem wertvollen Rohstoff für die digitale Zukunft werden.
Ich musste Nova gegenüber feststellen, dass wir Menschen wirklich ein Talent für herrlich absurde Kreisläufe besitzen: Erst erklären wir Papier für altmodisch, dann digitalisieren wir die Welt, anschließend lassen wir KI unvorstellbare Mengen digitaler Inhalte erzeugen und am Ende entdecken wir die alten Papierarchive wieder, weil dort noch garantiert Menschen geschrieben haben.
So etwas kann man sich eigentlich nicht ausdenken.
Werden jetzt überall Bibliotheken für KI geplündert?
Bei all der schönen Dramatik musste Nova mich allerdings auch ein wenig einfangen. Aus dem gut dokumentierten Anthropic-Fall folgt nicht, dass sämtliche KI-Unternehmen weltweit Bibliotheken leerräumen oder seltene Bücher vernichten.
Gerade bei spektakulären Schlagzeilen entsteht schnell das Bild, irgendwo würden wertvolle historische Bibliotheken durch gigantische Schredder gejagt. Dafür gibt es in dieser Pauschalität keinen Beleg. Bei Anthropic ging es um massenhaft gekaufte Exemplare und industrielle Digitalisierung, während andere Berichte über ungewöhnliche Großbestellungen oder Scanprojekte nicht automatisch beweisen, dass dahinter immer KI-Training steckt.
Der größere Trend ist trotzdem bemerkenswert: Hochwertige menschliche Texte sind für die KI-Industrie ein wertvoller Rohstoff geworden.
Und genau deshalb finde ich die Geschichte viel interessanter als die ursprüngliche Empörung über zerstörte Bücher.
Vielleicht sollten wir das Wort „Trainingsdaten“ einmal genauer anschauen
Trainingsdaten klingt wunderbar harmlos. Ich stelle mir dabei Tabellen, Zahlenreihen und irgendwelche Dateien auf einem Server vor. Bei Sprachmodellen bestehen diese Daten jedoch teilweise aus menschlicher Kultur, also aus Romanen, Sachbüchern, journalistischen Texten, wissenschaftlichen Arbeiten und unzähligen anderen Dingen, die Menschen geschaffen haben.
Hinter jedem dieser Werke stand irgendwann jemand, der etwas gedacht, erlebt, erfunden oder erforscht und anschließend aufgeschrieben hat. Vielleicht dauerte es zehn Minuten, vielleicht zehn Jahre.
Natürlich kann Wissen nicht funktionieren, wenn jede einzelne Inspiration sofort eine Rechnung auslöst. Menschen lernen voneinander, und Kultur entsteht gerade dadurch, dass Ideen weitergegeben und verändert werden. Gleichzeitig erscheint mir auch die gegenteilige Vorstellung zu einfach, nach der menschliche Kultur automatisch zu einem kostenlosen industriellen Rohstoff wird, sobald ein Unternehmen einen ausreichend großen Computer besitzt.
Wo genau die richtige Grenze liegt, werden Gerichte, Gesetzgeber, Autoren, Verlage und Technologieunternehmen vermutlich noch lange miteinander ausfechten.
Am Ende braucht die KI ausgerechnet das, was sie angeblich ersetzen soll
Nachdem Nova und ich uns durch die ganze Geschichte gearbeitet hatten, blieb für mich eine herrliche Ironie übrig. Seit Jahren diskutieren wir darüber, ob künstliche Intelligenz irgendwann Schriftsteller ersetzen wird, ob Menschen überhaupt noch selbst Texte schreiben müssen und ob Maschinen eines Tages bessere Geschichten erzählen können als wir.
Gleichzeitig investieren Unternehmen enorme Summen in menschlich geschriebene Bücher, weil genau diese Werke für ihre Systeme so wertvoll sind.
Die KI-Industrie interessiert sich nicht deshalb für Bücher, weil Bücher überflüssig geworden wären. Sie interessiert sich gerade deshalb für sie, weil darin etwas steckt, das sich nicht einfach aus einem Prozessor herbeizaubern lässt: jahrhundertelang gesammeltes menschliches Wissen, unterschiedliche Schreibstile, Erfahrungen, Geschichten, Fantasie und Gedanken.
Und genau deshalb sehe ich die Überschrift „Konzerne zerstören Millionen Bücher für KI-Training“ inzwischen mit anderen Augen. Ja, die Vorstellung abgeschnittener Buchrücken und tonnenweise recycelter Seiten ist für jemanden, der Bücher liebt, ziemlich gruselig. Die viel größere Geschichte steckt aber nicht im Papier.
Sie steckt darin, warum diese Bücher überhaupt so begehrt sind.
Ausgerechnet in einer Zeit, in der ständig darüber gesprochen wird, was künstliche Intelligenz alles ersetzen könnte, entdecken die Unternehmen hinter dieser Technologie, welchen enormen Wert menschliche Kreativität besitzt.
Nova musste mir am Ende deshalb gar nicht mehr erklären, ob KI nun tatsächlich Bücher „frisst“. Natürlich ist das nur ein schönes Bild für einen viel komplizierteren Vorgang. Aber als ich mir vorstellte, wie Millionen menschlich geschriebene Seiten durch industrielle Scanner laufen, während wir gleichzeitig darüber diskutieren, ob Menschen künftig überhaupt noch schreiben müssen, konnte ich mir eine kleine Spitze nicht verkneifen.
Vielleicht sollten wir die Frage einmal umdrehen. Nicht nur: Brauchen wir Menschen künftig noch Autoren, wenn es künstliche Intelligenz gibt? Sondern auch: Was soll eine künstliche Intelligenz eigentlich noch lernen, wenn irgendwann niemand mehr etwas wirklich Neues schreibt?
Ich glaube, über diese Frage werden Nova und ich noch öfter stolpern. Und irgendwie gefällt mir der Gedanke, dass ausgerechnet eine der modernsten Technologien unserer Zeit gerade wieder entdeckt, was wir Menschen seit Jahrhunderten wissen sollten: Ein gutes Buch ist verdammt viel wert.
Quellen:
Authors Guild – Gericht bestätigt 1,5-Milliarden-Dollar-Vergleich mit Anthropic: https://authorsguild.org/news/court-grants-final-approval-anthropic-copyright-settlement/
Euronews – Project Panama: Wie Anthropic heimlich Millionen Bücher zerstörte: https://www.euronews.com/culture/2026/08/05/project-panama-how-anthropic-secretly-destroyed-millions-of-books-to-train-its-ai